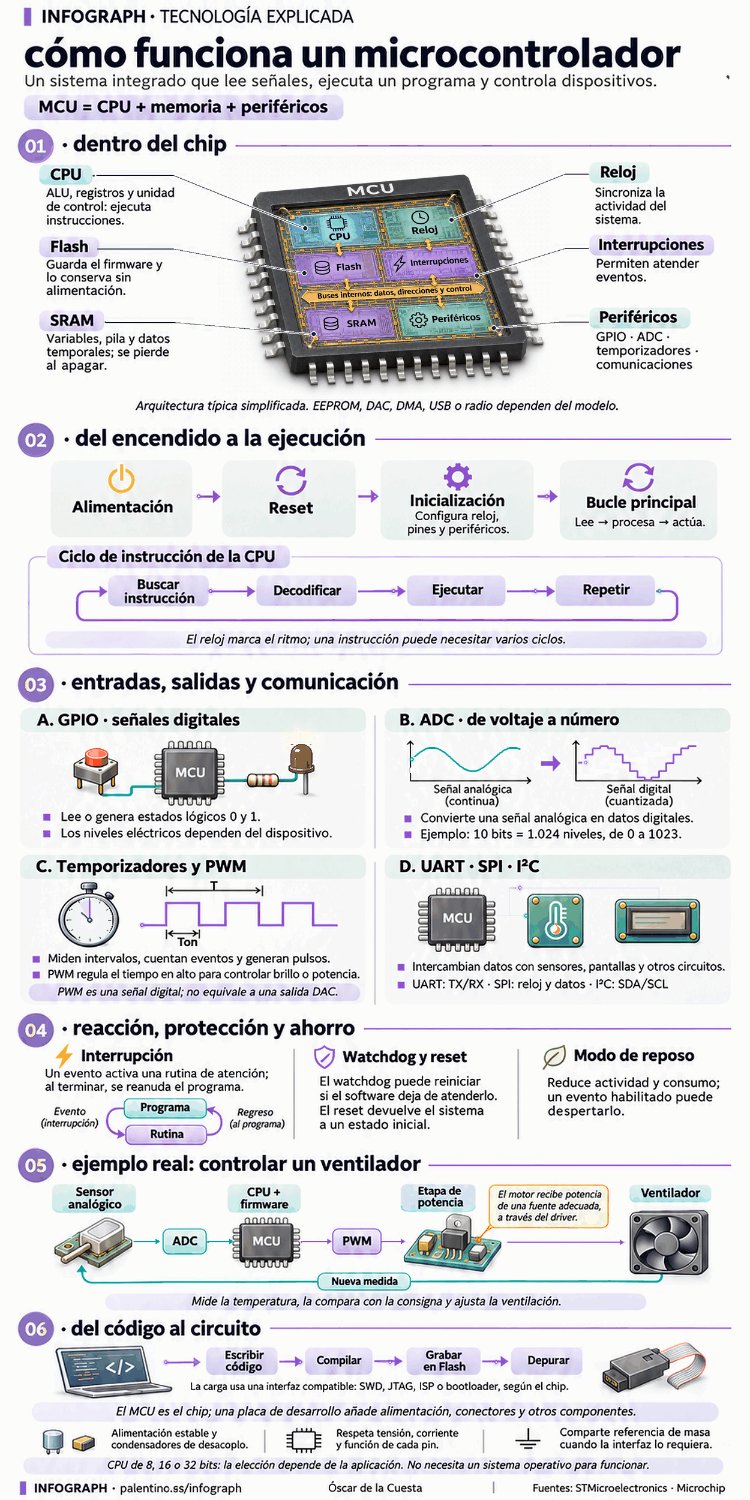
GIF animado
 infograph/ palentino.es
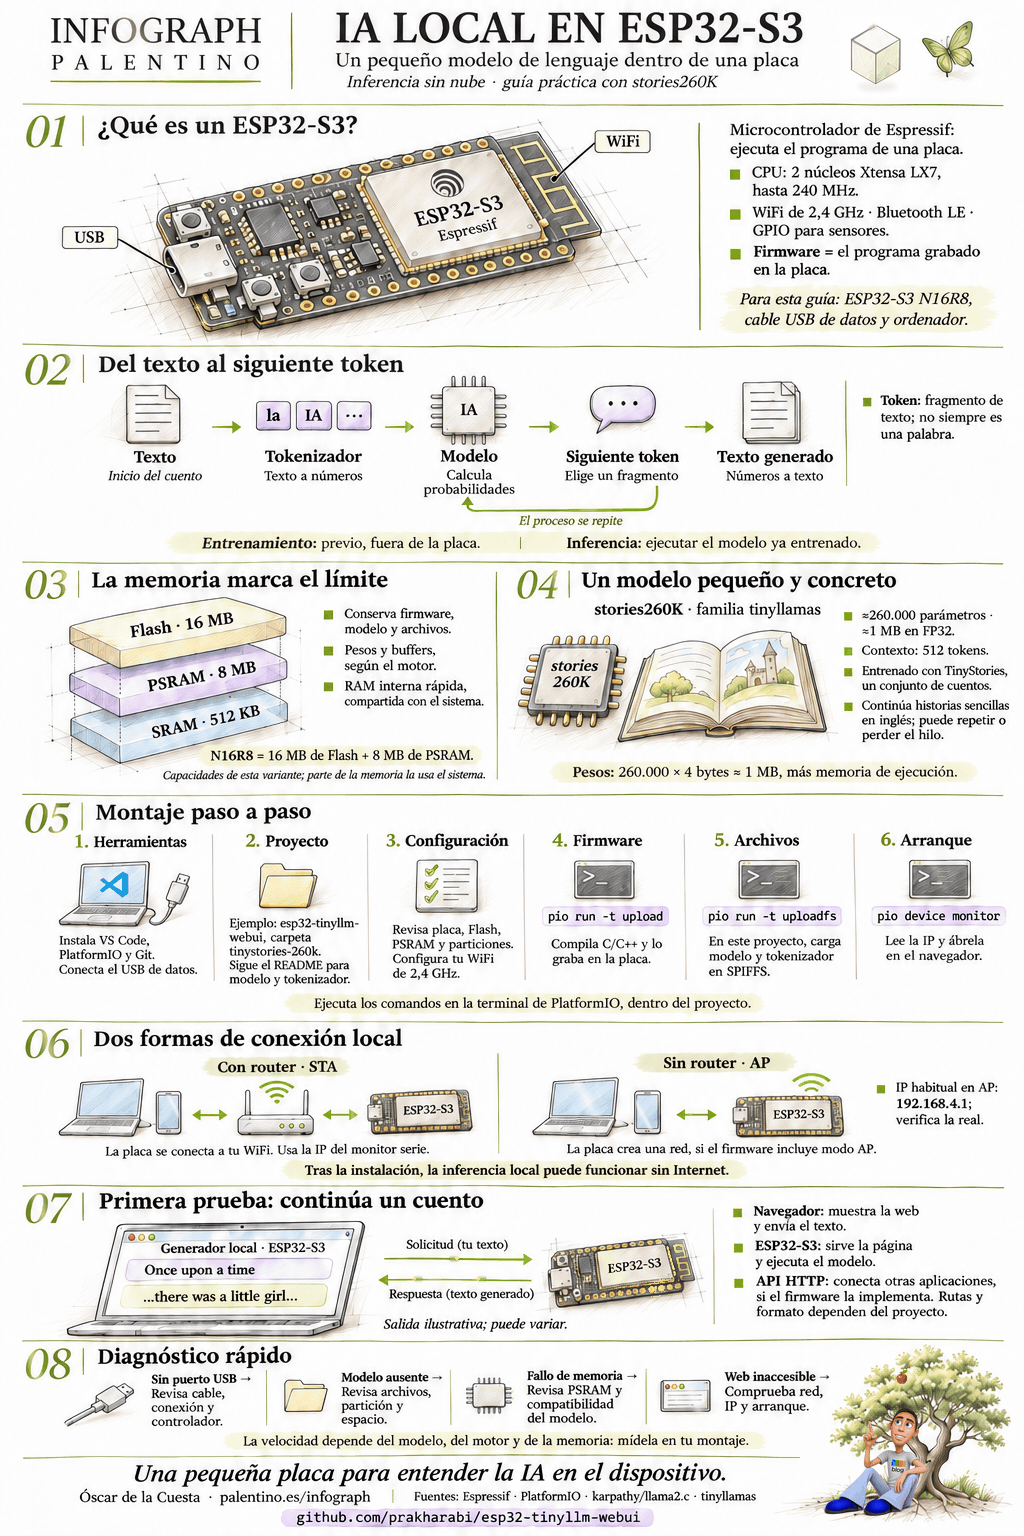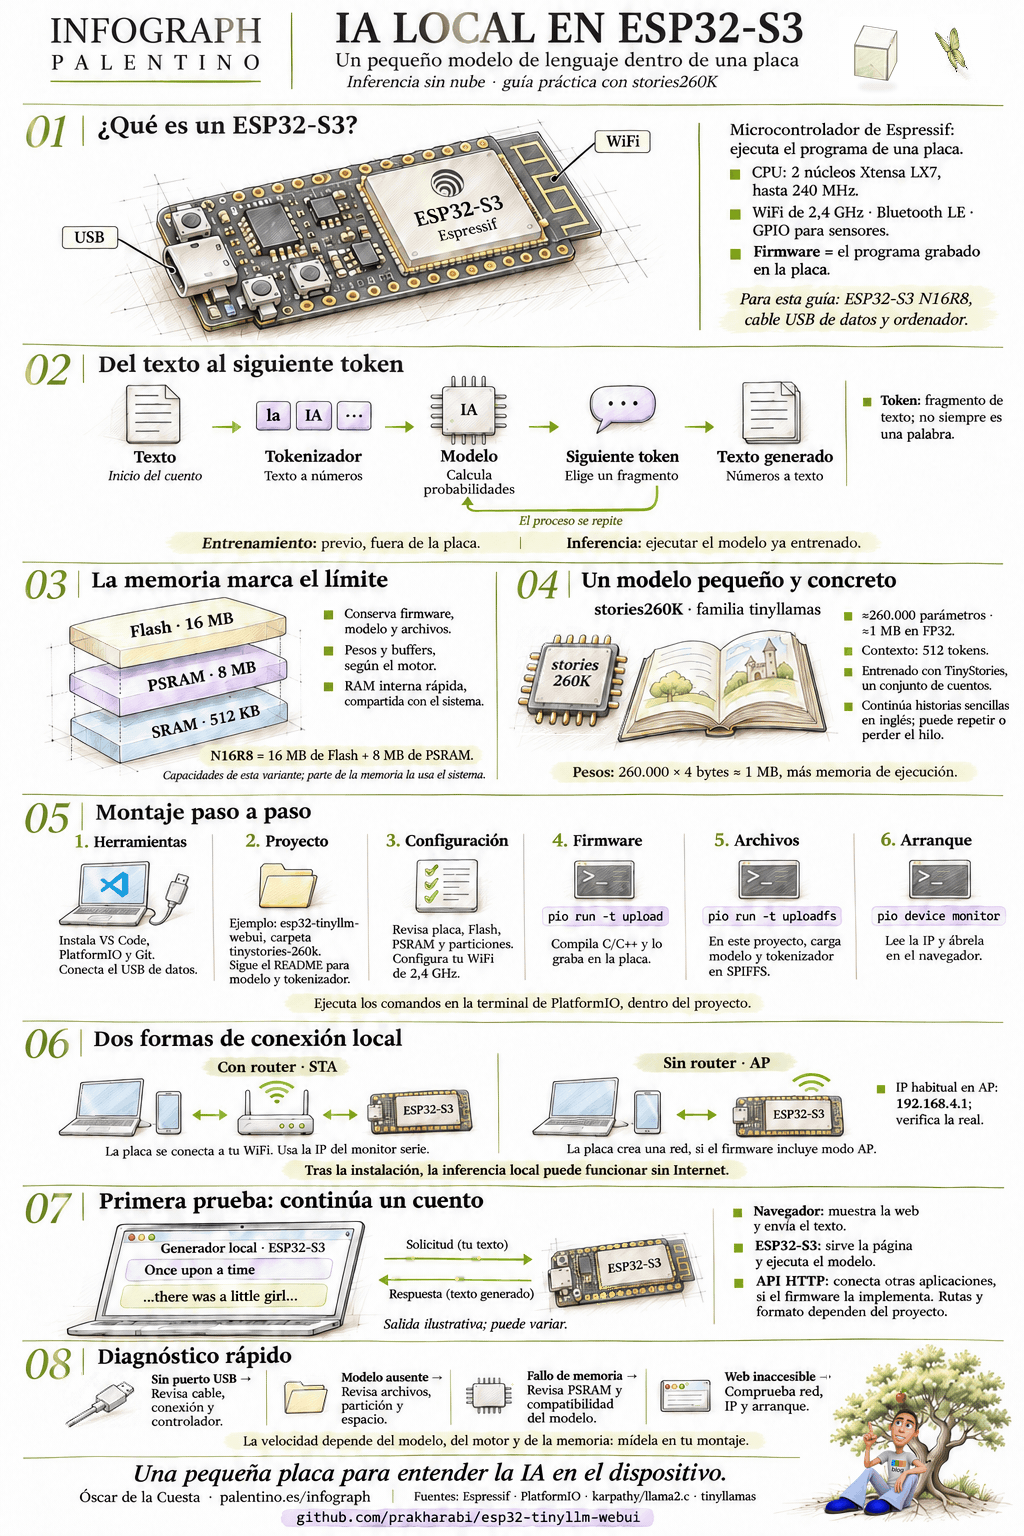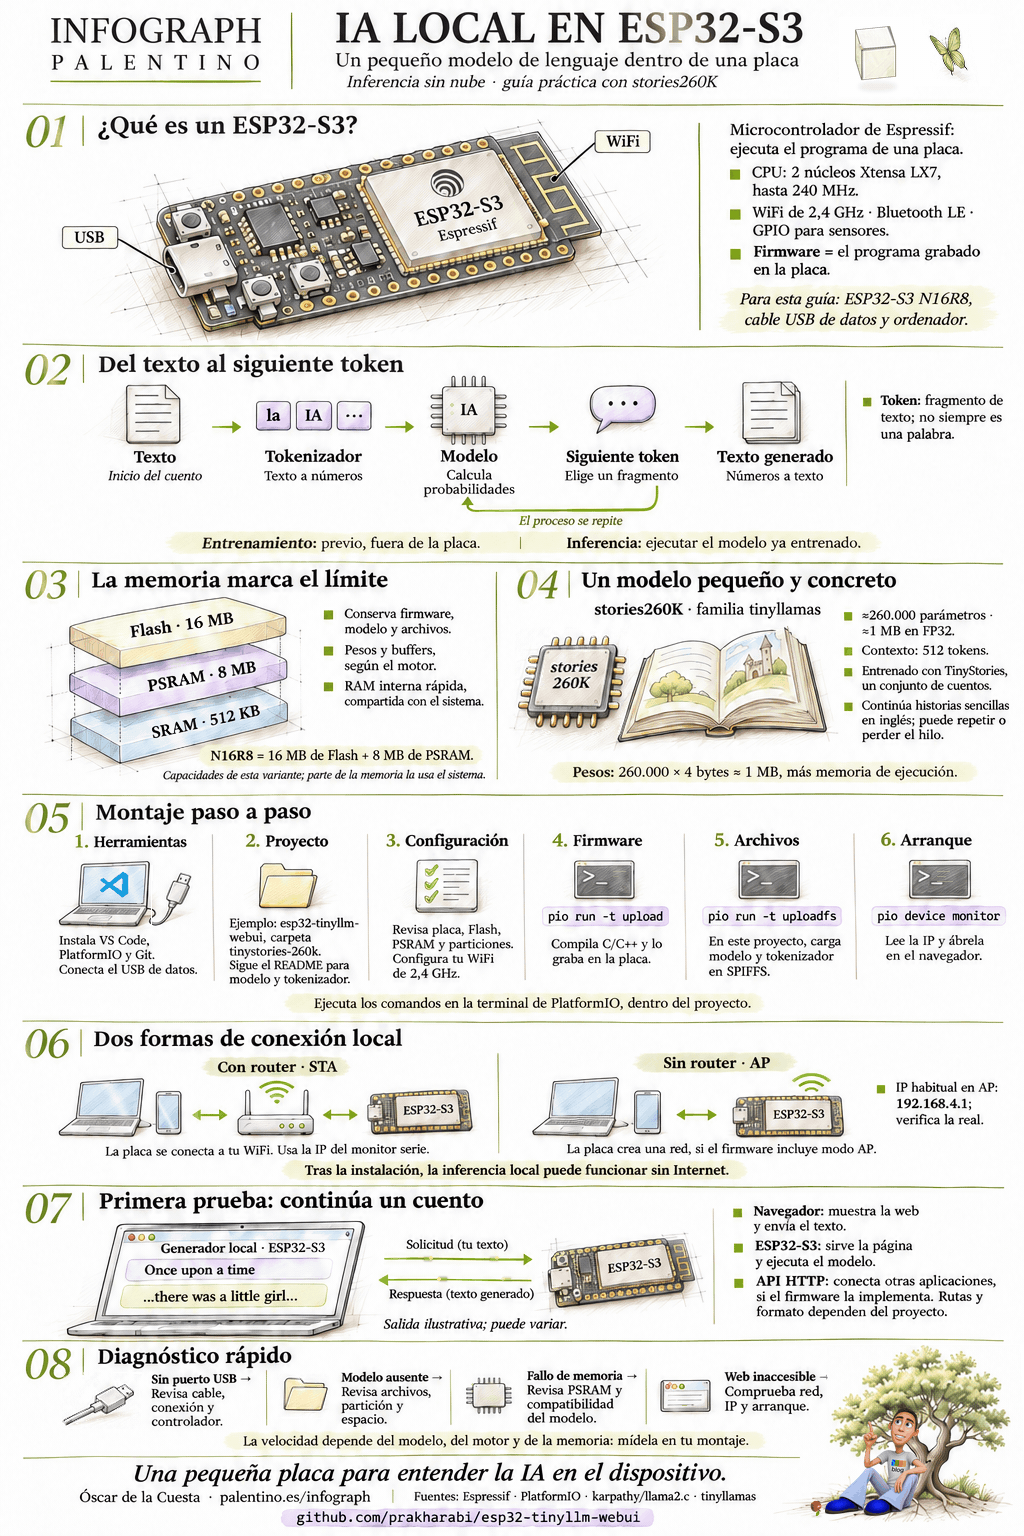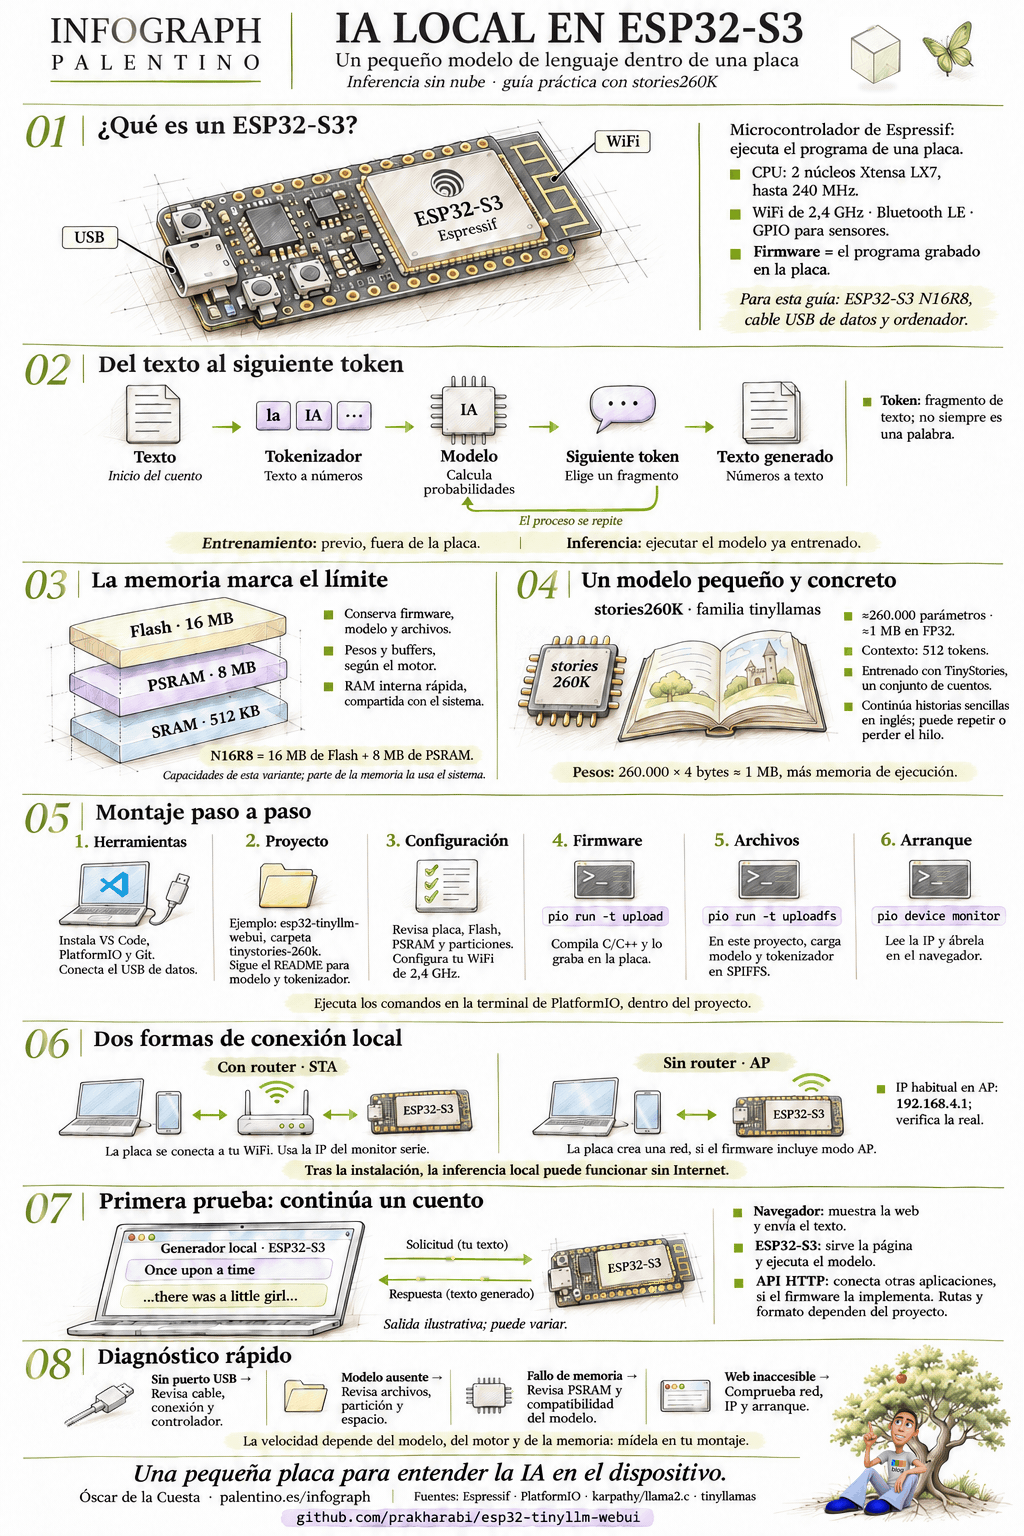
PARA ENTENDER EL ESQUEMA
Un pequeño modelo de lenguaje, una placa que cabe en la mano y texto generado en el propio dispositivo. Así se puede empezar a experimentar con IA local en un ESP32-S3.
Me parece una forma muy interesante de acercarse a la inteligencia artificial desde el hardware: entender qué se ejecuta, dónde se guarda el modelo y cómo se genera cada fragmento de texto.
Pero empecemos por el principio.
El ESP32-S3 es un microcontrolador de Espressif, con procesador de dos núcleos, WiFi, Bluetooth LE y conexiones para trabajar con sensores y otros dispositivos. Ejecuta un firmware: el programa que grabamos en la placa.
Para el ejemplo de la lámina se utiliza una variante N16R8, con tres tipos de memoria:
🔸 16 MB de Flash: conserva el firmware, el modelo y los archivos.
🔸 8 MB de PSRAM: proporciona espacio para los pesos y los buffers, según el motor.
🔸 512 KB de SRAM: memoria interna rápida, compartida con el sistema.
La memoria importa mucho. Además de almacenar el modelo, hace falta espacio para ejecutarlo.
El ejemplo utiliza stories260K, de la familia tinyllamas, entrenado con el conjunto de cuentos TinyStories. Tiene unos 260.000 parámetros y ocupa aproximadamente 1 MB en FP32, más la memoria necesaria durante la ejecución.
Su tarea es concreta: continuar cuentos sencillos en inglés. Puede repetir frases o perder el hilo, algo que también permite observar los límites de un modelo tan pequeño.
El recorrido es este:
Texto → tokenizador → modelo → siguiente token → continuación del texto.
Un token es un fragmento de texto; no siempre coincide con una palabra. El modelo genera uno, lo incorpora a la secuencia y vuelve a calcular el siguiente.
El entrenamiento se realizó previamente, fuera de la placa. Aquí estamos ejecutando inferencia local.
Para montarlo, el recorrido pasa por instalar VS Code, PlatformIO y Git; abrir un proyecto compatible; revisar la configuración de memoria y WiFi; grabar el firmware, el modelo y el tokenizador; y consultar la IP para acceder desde el navegador.
El navegador muestra la interfaz. La placa ejecuta el modelo.
Una vez instalado, la inferencia puede funcionar sin Internet. El modo de conexión directa mediante un punto de acceso y la disponibilidad de una API HTTP dependen del firmware elegido.
En esta nueva lámina animada de Infograph he reunido el proceso completo, con el montaje, las conexiones y un pequeño diagnóstico de fallos. Y he añadido un guiño a Newton bajo el árbol. 🍎
Una práctica para aprender cómo se encuentran el código, la memoria, las redes y la IA dentro de un dispositivo.
🌐 palentino.es/infograph